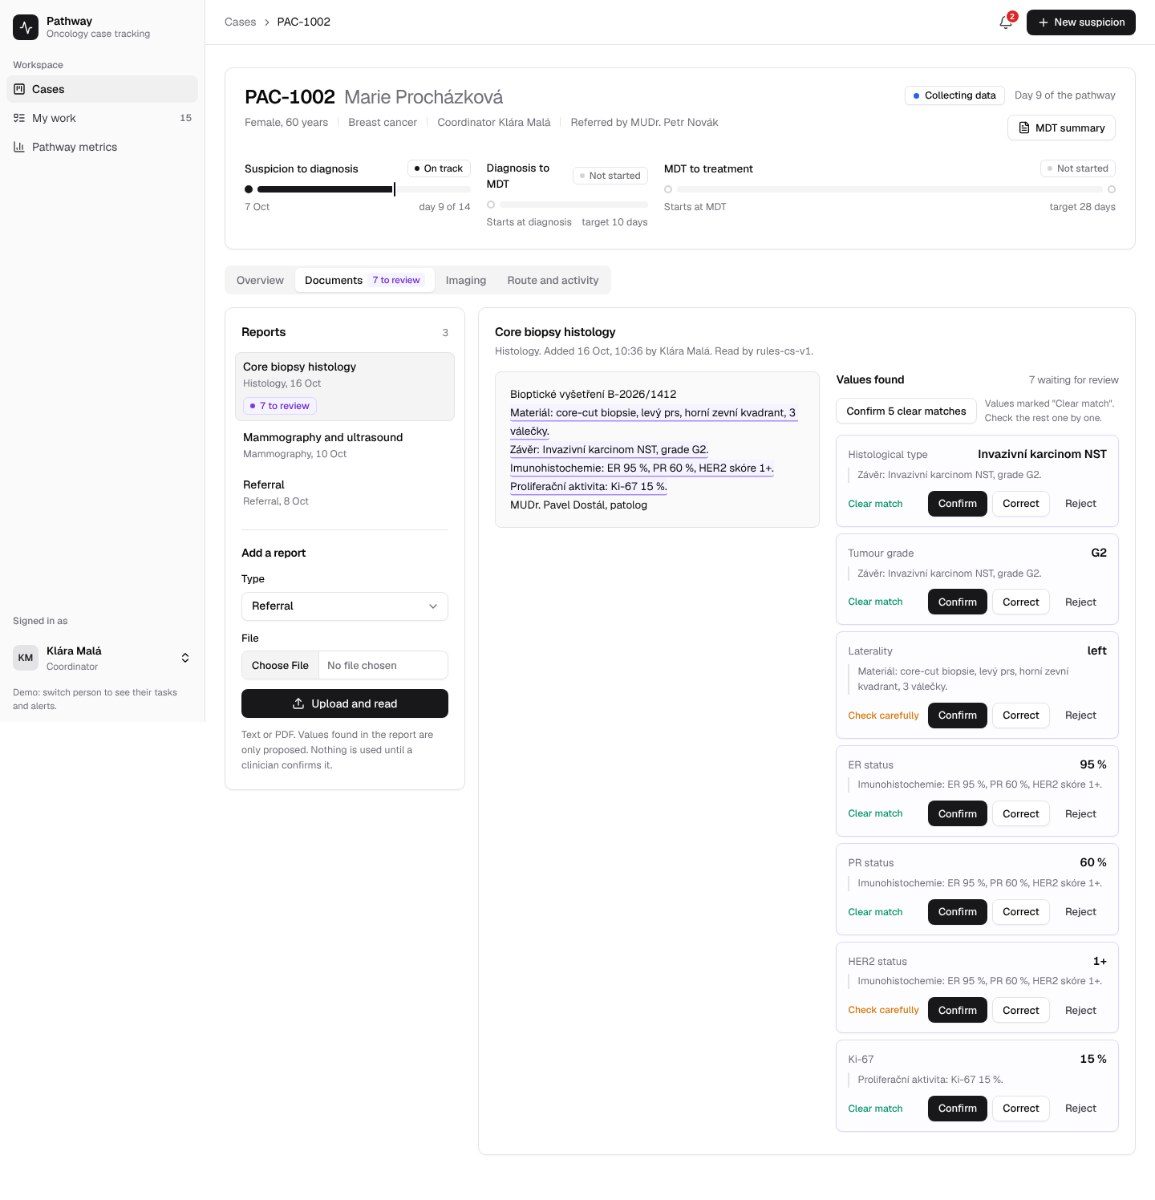
Jeden sdílený případ na každého pacienta s rakovinou: cura. čte zprávy, převádí mezery v informacích na úkoly s termíny a každou mamografii nechává znovu zkontrolovat umělou inteligencí.
Problém: Než začne léčba rakoviny prsu, pacientka projde rukama pěti odborníků: doporučujícího lékaře, mamografického pracoviště, patologie, onkologického centra (KOC) a multidisciplinárního týmu (MDT). Zprávy se předávají v tištěné podobě i ve formátu PDF. Hodnoty jako ER, HER2 a Ki-67 se přepisují ručně, nikdo nemá přehled o celém případu a zmeškané termíny se odhalí až na zasedání MDT.
Co jsme vytvořili: cura představuje jeden sdílený případ pro každého pacienta, který používají všichni odborníci.
- Zprávy: Nahrajte zprávu a cura z ní načte hodnoty. Každá hodnota je propojena s větou, ze které pochází, a klinický pracovník ji potvrdí, než se započítá. Čtení provádí model LLM, přičemž jako záložní řešení slouží offline čtečka založená na pravidlech.
- Úkoly a termíny: Chybějící nálezy se promění v úkoly s odpovědnou osobou a termínem splnění. Každý krok je sledován vzhledem k cíli, takže se zpoždění projeví včas.
- Připraveno pro MDT: Jakmile je případ kompletní, označí se jako připravený a vygeneruje se souhrn pro MDT.
- AI pro zobrazovací diagnostiku: Každý mamogram (PNG, JPEG nebo DICOM) se odešle do modelové služby, která jej vyhodnotí a zobrazí teplotní mapu oblastí, které model prozkoumal. Radiolog zaznamená skóre BI-RADS a uvede, zda s ním souhlasí. Model pouze navrhuje; nikdy nerozhoduje.
- Metriky postupu: Počet dní na jednotlivé kroky ve srovnání s cílovými hodnotami a čekací doby mezi jednotlivými poskytovateli, aby VZP mohla zjistit, kde pacienti čekají.
Data: Veškerá data pacientů v ukázce jsou syntetická. Mamografický model je EfficientNet-B0 trénovaný na veřejném datovém souboru Kaggle (INbreast, MIAS a DDSM). Tento datový soubor ukládá otočené kopie jednotlivých mamogramů jako samostatné soubory, takže při naivním rozdělení dochází k úniku informací: veřejně dostupné notebooky, které jsme zkontrolovali, uvádějí z tohoto důvodu přesnost 99 až 100 %. Kopie jsme seskupili a rozdělili podle skupin. Na testovacích mamogramech dosahuje model přesnosti 94,9 % (benigní / maligní / normální) a označuje malignitu s citlivostí 95 % a specificitou 95 %. Zjistili jsme také, že část tohoto skóre pochází z artefaktů datového souboru v pozadí snímku, proto jej považujeme za horní hranici, nikoli za klinický výkon.
Stack: Go a htmx, PostgreSQL a model PyTorch na FastAPI, vše v kontejnerech.
Co bude dál? Otestujeme postup pro diagnostiku rakoviny prsu v jednom onkologickém centru a změříme dobu do zahájení léčby před a po zavedení. Propojíme eŽádanku, nemocniční systémy přes HL7 FHIR a PACS. Spustíme čtečku zpráv na lokálním LLM a všechna data budeme uchovávat na místě. Model přetrénujeme s maskovaným pozadím a ověříme jej na vlastních snímcích centra. Poté přidáme další typy rakoviny jako konfiguraci.
- Měli už předtím
- We had only the data which was from a public dataset, the application was fully built during the hackathon.
- Využití AI
- Two AI parts, both checked by a person before anything counts.
Report reader: an LLM (Claude Sonnet, swappable for a local model) reads histology, imaging and staging reports and extracts values such as ER, PR, HER2, Ki-67 and TNM. Every value links to the exact sentence it came from, and a clinician confirms or corrects it before it enters the case. A rule-based reader runs offline as a fallback.
Imaging: our own EfficientNet-B0, trained on public mammograms (INbreast, MIAS, DDSM, Kaggle). It scores malignancy and shows a heatmap of where it looked. We split train and test by source image, because rotated copies of each mammogram leak otherwise. On held-out data: 94.9% accuracy, 95% sensitivity, 95% specificity. Tests showed part of that comes from image-background artifacts, so we report it as an upper bound. The radiologist records BI-RADS and agrees or disagrees, and every prediction is stored with its model version, so real-world agreement is measured. - Dopad
- About 7,600 to 7,900 women in Czechia are diagnosed with breast cancer each year, and each passes through around five providers before treatment.
Time saved: clinicians confirm extracted values instead of retyping them. If that saves about 10 minutes per report across about 5 reports per patient, that is roughly 6,500 clinician hours a year for breast cancer alone.
Fewer errors and repeats: one source per value, linked to its sentence, removes copy errors in ER, HER2 or Ki-67 and the repeat tests they cause.
Faster treatment: missing steps become tasks with owners and deadlines, so gaps show up days or weeks before the MDT, not at it.
Measured waits: VZP sees days per step and per provider for the first time, and can set and check targets.
On-premise: everything is offline, deployed on the clinic premise and can be extended and interconnected with other systems using custom middleware to protect the data and ehnance the quality of the data and treatment for a patient. - Komu pomůže
- Pacienti a jejich blízcí, Lékaři a sestry, Nemocnice a poskytovatelé péče, Zdravotní pojišťovny, Výzkum
- Technologie InterSystems
- Ano — We only use vector search to gather data from scientific medical articles that can pair up with the patient data and provide insights for both the doctors and the patients on what they can try out to improve their medical records.
Strojový překlad z angličtiny
- Tým
- smetytech. — Vladut Dinu, Andrei Constantin, Bogdan Musat, Mihnea Hututui
- Výzva
- Cesta pacienta bez ztráty informací · Praha