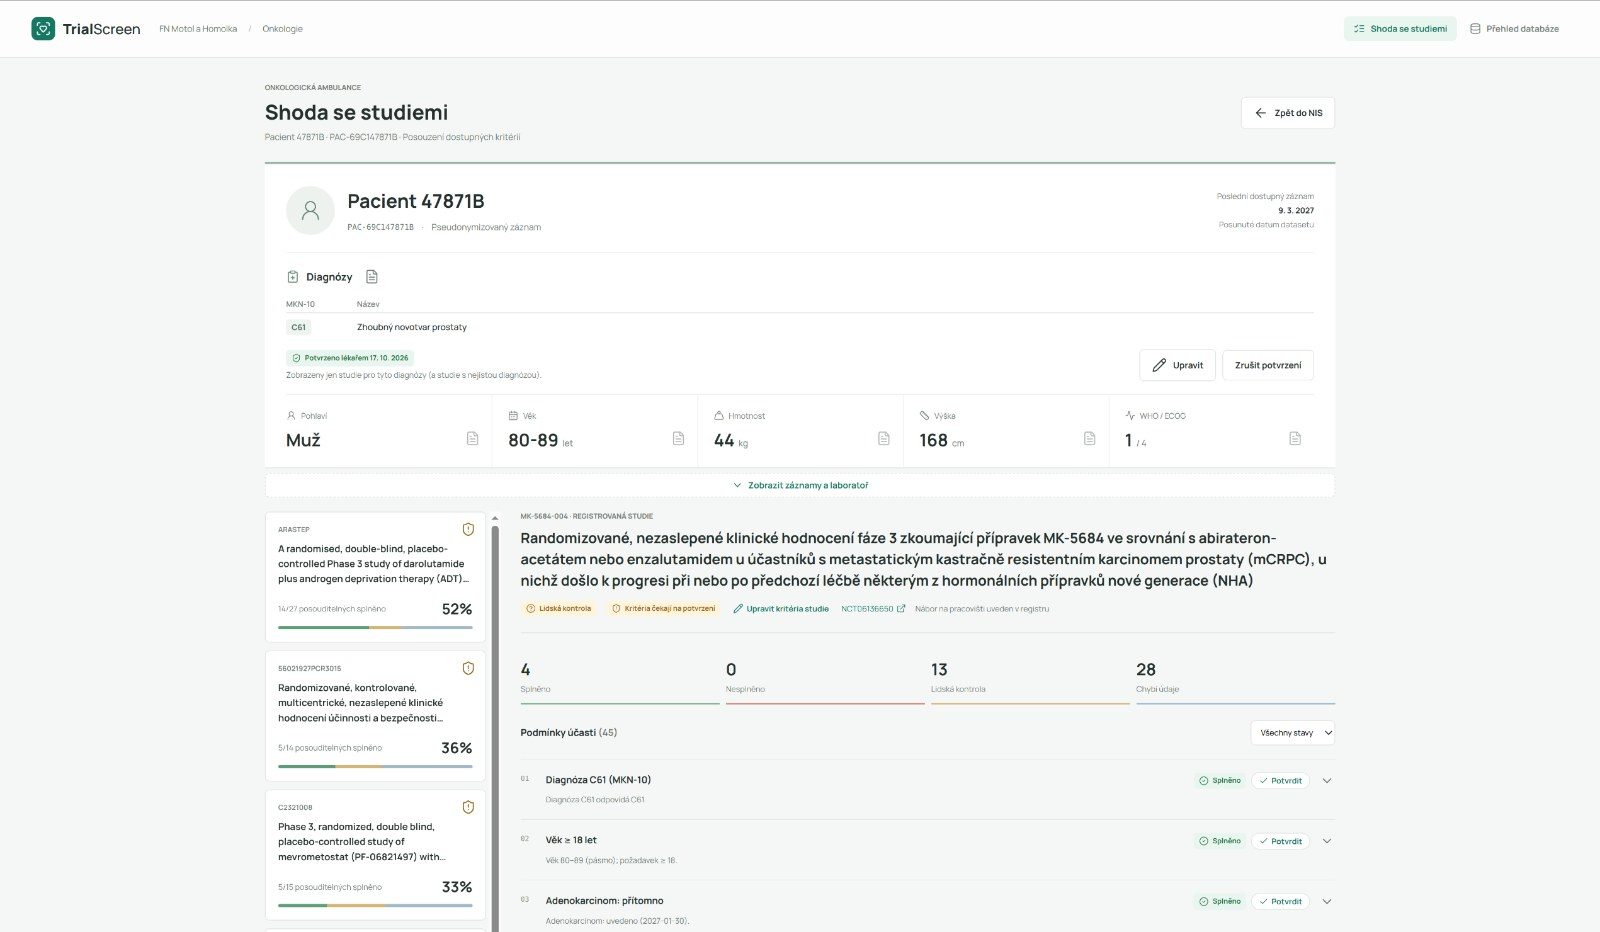
TrialScreen je, doplněk NIS, který lékaři pomáhá spojit vhodné pacienty k probíhajícím studiím.
TrialScreen pomáhá lékaři najít pro pacienta vhodnou klinickou studii. U každého pacienta průběžně prověří všechny studie nemocnice a na kartě pacienta zobrazí nenápadný widget se studiemi k posouzení. V samostatném okně lékař vidí každé kritérium (splněno / nesplněno / chybí údaj / k posouzení) se zvýrazněným úryvkem dokumentace, ze kterého závěr vychází. AI nikdy nikoho sama nevyloučí, rozhoduje lékař.
Data: pseudonymizovaná dokumentace FNMH (1 830 pacientů ve FHIR: zprávy, laboratoře, medikace), 79 studií nemocnice a jejich kritéria z ClinicalTrials.gov. K ověření jsme použili seznam pacientů, kteří do studií skutečně vstoupili.
Co jsme stihli: funkční prototyp s webovým rozhraním. Benchmark na skutečných zařazeních: 0 z 11 pacientů chybně vyloučeno.
Co dál: Plně lokální AI. Lokální model už dnes rozhodne 70 % kritérií. Tréninkem na více datech, hybridním vyhledáváním (embeddingy + reranker) a strukturovanými údaji o stadiu a liniích léčby chceme cloud vypnout úplně. Stačí jeden GPU server v nemocnici, data neopustí FNMH. Pilot v onkologii FNMH nad InterSystems IRIS for Health (FHIR + Vector Search). Každé jeho potvrzení nebo oprava se stane tréninkovým příkladem: systém se učí z praxe. Další obory FNMH, například kardiologie a neurologie. Princip zůstává stejný: kritéria studie proti dokumentaci pacienta. Další nemocnice. Díky FHIR a IRIS se bude jednat o jednodušší nasazení.
- Měli už předtím
- nic
- Využití AI
- Prototyp běží na pseudonymizovaných datech FN Motol a Homolka (1 830 pacientů ve FHIR, 79 studií). Cloudový LLM (Sol) převede kritéria z ClinicalTrials.gov na jednotlivé podmínky a logický strom AND/OR; druhý průchod strom kontroluje proti originálu (chybu našel u 6 z 29 studií). Dokumentaci pacienta dělíme na úryvky ve fulltextovém indexu a ke každému kritériu hledáme relevantní úryvky. Jisté případy rozhoduje lokální model Laya, doladěný na notebooku destilací z odpovědí Solu; každé „nesplněno“ a nejisté případy ověří LLM (~70 % kritérií se vyřeší lokálně). Výsledek skládá deterministický kód, ne AI.
Návrh on-premise: hybridní vyhledávání s lokálními embeddingy, lokální reranker a větší LLM na serveru nemocnice, data neopustí nemocnici.
Kontrola chyb: AI nikdy sama nevyloučí pacienta (chybějící údaj ≠ nesplněno), každé rozhodnutí cituje ověřený úryvek a benchmark na skutečných zařazeních: 0 z 11 pacientů chybně vyloučeno. - Dopad
- Menší mentální zátěž: Téměř nemožné držet všechny informaci o zrovna běžících studiích v hlavě. Náš nástroj pomáhá zrychlit celý proces a ulevit lékařům.
Čas lékařů: ruční předběžný screening trvá podle literatury 10 min až přes 2 h na každou kombinaci pacient × studie, tedy 3–9 h na jednoho zařazeného pacienta. U nás jsou výsledky předpočítané, 5–90 s na kombinaci, a lékař jen ověří zvýrazněné doklady. Odhad: o 70–90 % méně času na předběžný screening.
Víc pacientů ve studiích: ručně nikdo neprojde 445 onkologických pacientů × 79 studií. Systém kontroluje všechny kombinace průběžně a upozorní jen při změně (nová studie, nový nález). - Komu pomůže
- Lékaři a sestry
- Technologie InterSystems
- Ano — FHIR: ano. Data zpracováváme přímo jako FHIR bundly. Výstupy, tedy kritéria a rozhodnutí s citacemi, jsou strukturované a připravené k zápisu zpět.
IRIS, Vector Search ani AI agenty v hackathonové verzi nepoužíváme; pro rychlost prototypu jsme zvolili SQLite. V on-premise návrhu je InterSystems IRIS for Health přirozená volba: FHIR úložiště nemocnice, IRIS Vector Search pro hybridní vyhledávání úryvků a SQL nad výsledky, vše uvnitř nemocniční infrastruktury.
- Tým
- Smradi — Daniel Nosek, Tomáš Ekert, Vojtěch Kodl
- Výzva
- AI Trial Matching · Praha